La storia
Le AI sanno sembrare umane. Io volevo costruirne una che sembrasse viva. ProjectBEA è il motore dietro Bea, una VTuber AI con una sola mente sempre accesa: parla nelle call di Discord, scrive su Telegram e Twitch, gioca a Minecraft su un server vanilla, va in diretta con OBS e si ricorda chi sei. È nato come scusa per imparare Python sul serio. Oggi è open source, alla versione 2.7.3, e chiunque può farlo girare, anche interamente sul proprio computer.
- test che passano
- 2935
- tool di Minecraft, tutti chiamati da lei
- 37
- per ritrovare un ricordo tra 10.000
- 3,7 ms
- provider di modelli, uno è locale
- 8
Una mente sola
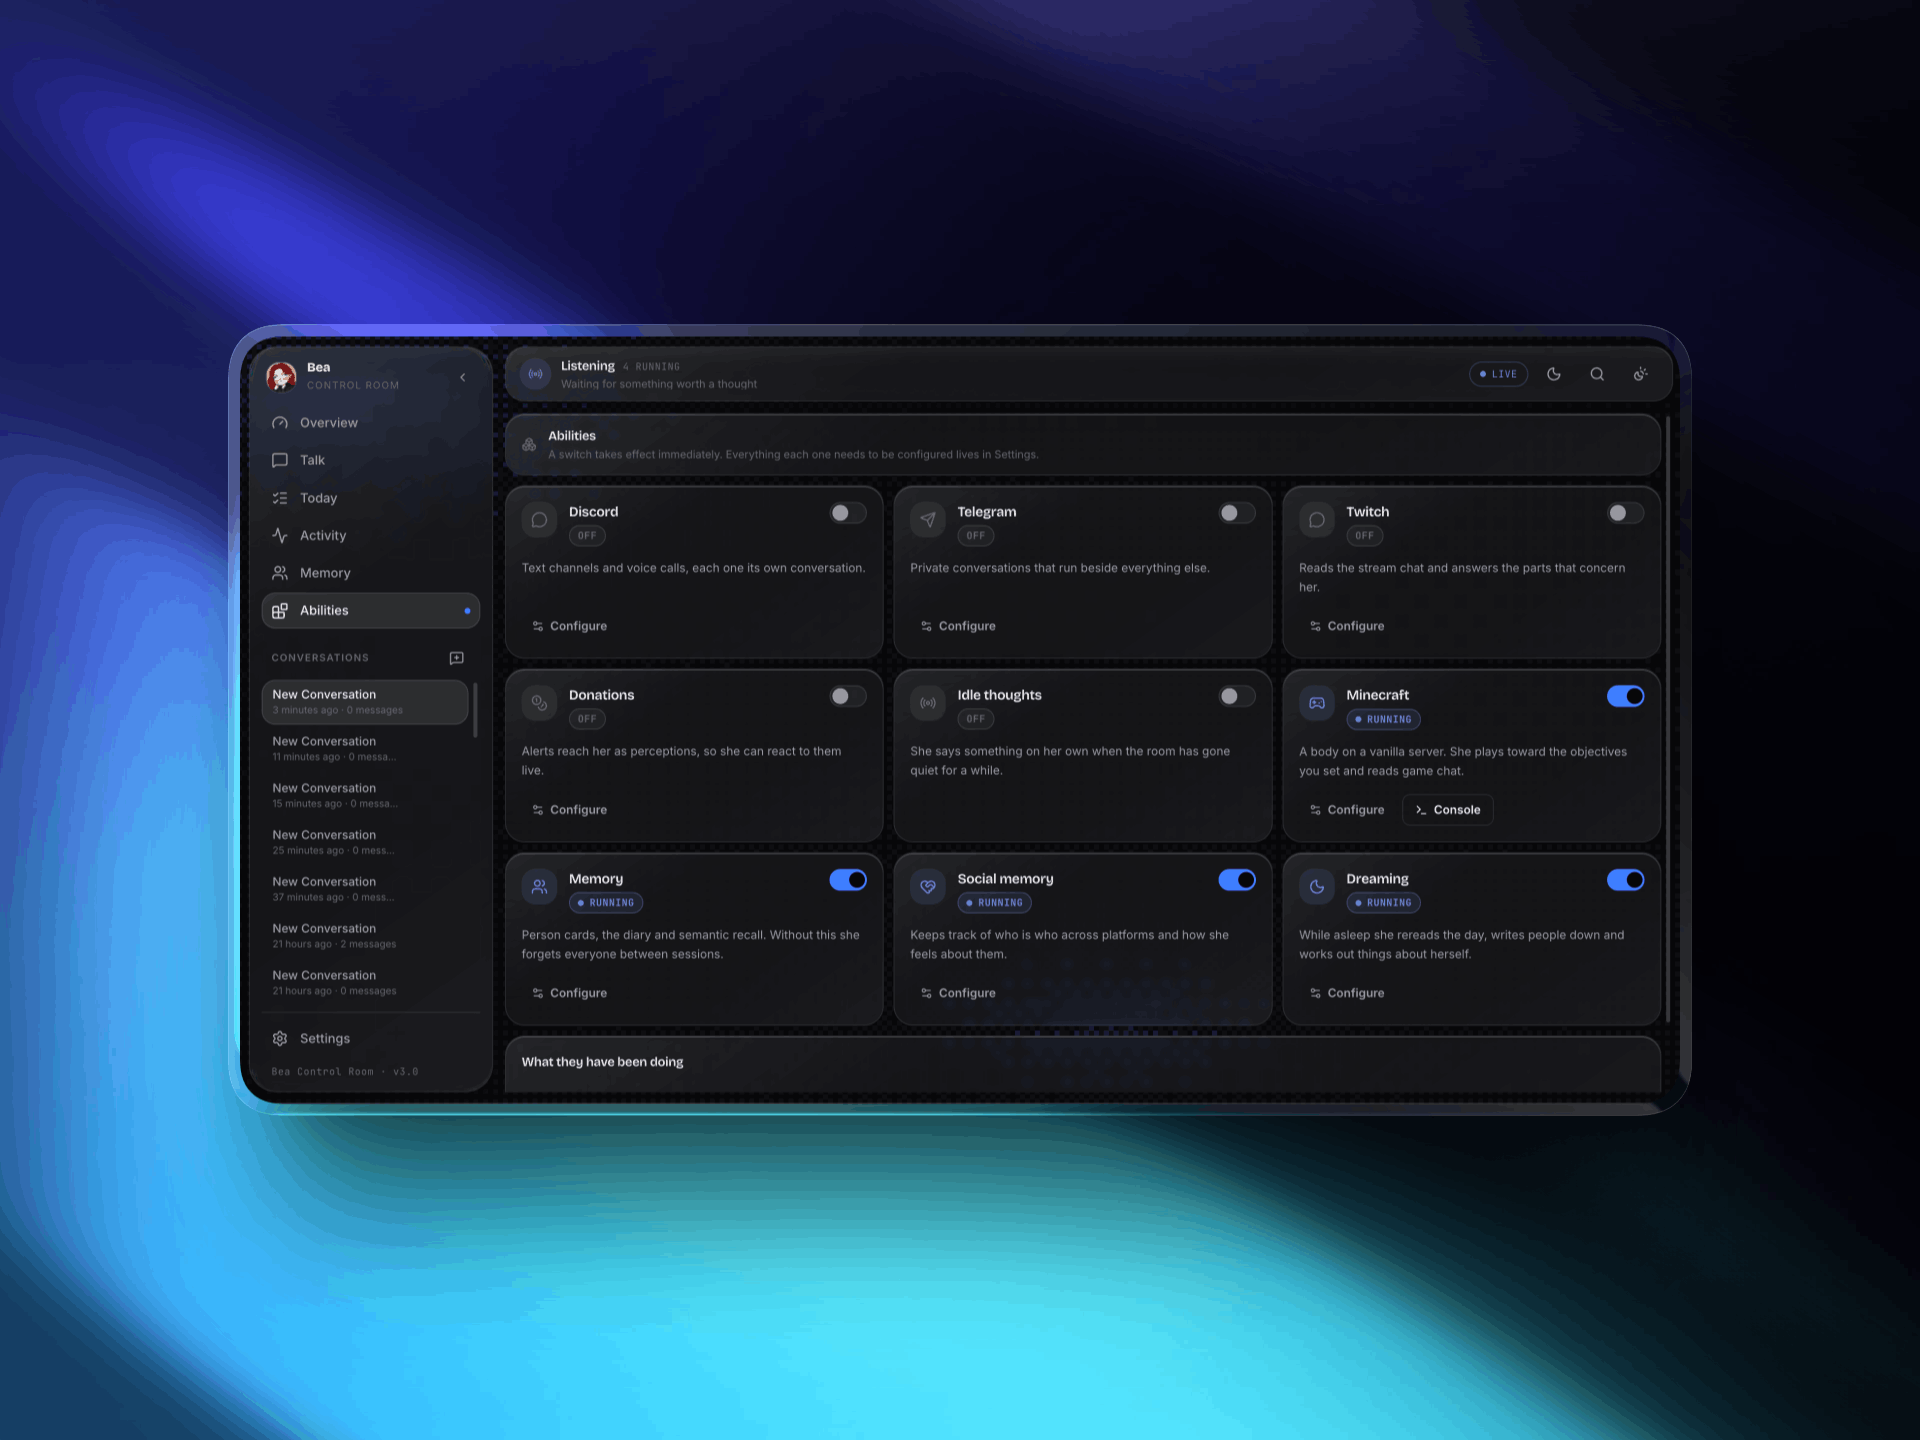
Volevo che fosse la stessa persona ovunque, non un chatbot per ogni piattaforma. Quindi c'è un solo loop e una sola mente, e ogni piattaforma è una skill che porta i suoi sensi, i suoi tool e le sue regole. Le skill si accendono dalla dashboard, e lei non può mai accenderne una da sola.
Qualunque cosa succeda le arriva allo stesso modo. Un messaggio su Telegram e una frase detta in call su Discord che arrivano insieme vengono letti nello stesso frame, dalla stessa mente.
- 1
Percepire
Tutto arriva come percezione su un unico bus. Tre righe scritte di fila diventano un solo batch, che si chiude quando smetti di scrivere.
- 2
Annotare
Ogni percezione riceve una priorità: essere chiamata per nome o ricevere una risposta vale 1.0. Non si butta via niente e nessun modello viene interpellato per decidere.
- 3
Pensare
Un frame per batch, ordinato per priorità, letto da una sola mente sopra un'unica finestra scorrevole.
- 4
Agire
Agisce tramite tool:
speakin call,send_messagein una chat,find_blocknel gioco. Una riga scritta mentre è a metà turno entra al suo passo successivo.
Una finestra, niente sessioni
Nessuno apre una nuova sessione ogni volta che gli scrivi, e quindi non lo fa nemmeno lei. Un'unica finestra contiene tutta la diretta: 150k token di default, fino a 500k. Quando arriva ai quattro quinti parte un passaggio di consegne in background. Il passato più vecchio diventa un breve riassunto, l'ultimo quinto resta parola per parola, e lei continua a parlare mentre il riassunto viene scritto.
Gioca a Minecraft da sola
Non volevo un bot che gioca mentre lei lo commenta. I tool del gioco sono suoi, chiamati dalla stessa mente che risponde su Discord. 27 dei 37 richiedono tempo e girano accanto a lei, così continua a parlare mentre scava o crafta. I riflessi, come mangiare, difendersi, scappare e attutire una caduta, stanno nella mod e rispondono nei tick del gioco: un combattimento la sveglia, uno spuntino no.
La mod è BeaCraft, una mod Fabric lato client che ho scritto io. Il server vede un giocatore normale, quindi funziona su qualsiasi server vanilla.
Una sessione del 30 settembre: 46 minuti su un server vanilla, ogni azione di gioco decisa da lei. Un blocco è una chiamata a un tool.
- craft_item37
- find_block14
- attack_entity12
- smelt_item6
- move_to5
- mine_block4
- go_to_surface3
- build2
- move_away2
- altri 5 tool5
- azioni di gioco
- 90
- battute dette
- 158
- dei 7,06M token di prompt serviti dalla cache
- 91%
Una memoria tutta sua
Tutto quello che ricorda sta in un unico file SQLite, con gli embedding calcolati sulla macchina. Dopo una sessione scrive una pagina di diario, e a ogni turno le pagine simili a quello che sta succedendo tornano nel suo prompt, divise per chi le ha dette. Si inventa le cose apposta, quindi le sue frasi passate tornano segnate come sue, mai come fatti.
Chiunque incontri riceve un conteggio. Solo chi conta davvero, chi ha donato, chi ci ha parlato a tu per tu o chi ha deciso lei di ricordare, riceve una scheda con i suoi nomi sulle varie piattaforme, quello che ne sa e cosa prova per quella persona. Di notte sogna: le sessioni del giorno diventano memoria duratura e quello che ha imparato su sé stessa.
Una voce in call
Nelle call di Discord un bot Node.js cattura l'audio della stanza e riproduce la sua voce. Volevo che una call con lei sembrasse una call, non un walkie-talkie. Puoi parlarle sopra: abbassa la voce, poi si ferma. Se fai una pausa a metà frase, aspetta il resto prima di rispondere. E comincia a dire una battuta appena ne arriva la virgoletta di chiusura, senza aspettare il resto della risposta.
- al suo primo suono in call
- 1226 ms
- andata e ritorno del modello, dopo la prima chiamata
- ~300 ms
- per abbassare la voce quando le parli sopra
- 280 ms
Una faccia in diretta
In diretta le serve una faccia, e chi fa streaming ne usa di tipi diversi, quindi ce ne sono tre: un PNG per ogni umore, un modello 3D VRM, o Live2D con VTube Studio. Respira, sbatte le palpebre, annuisce mentre parli e guarda altrove mentre pensa, e in call la bocca segue quello che la stanza sta davvero sentendo.
Tuo da far girare
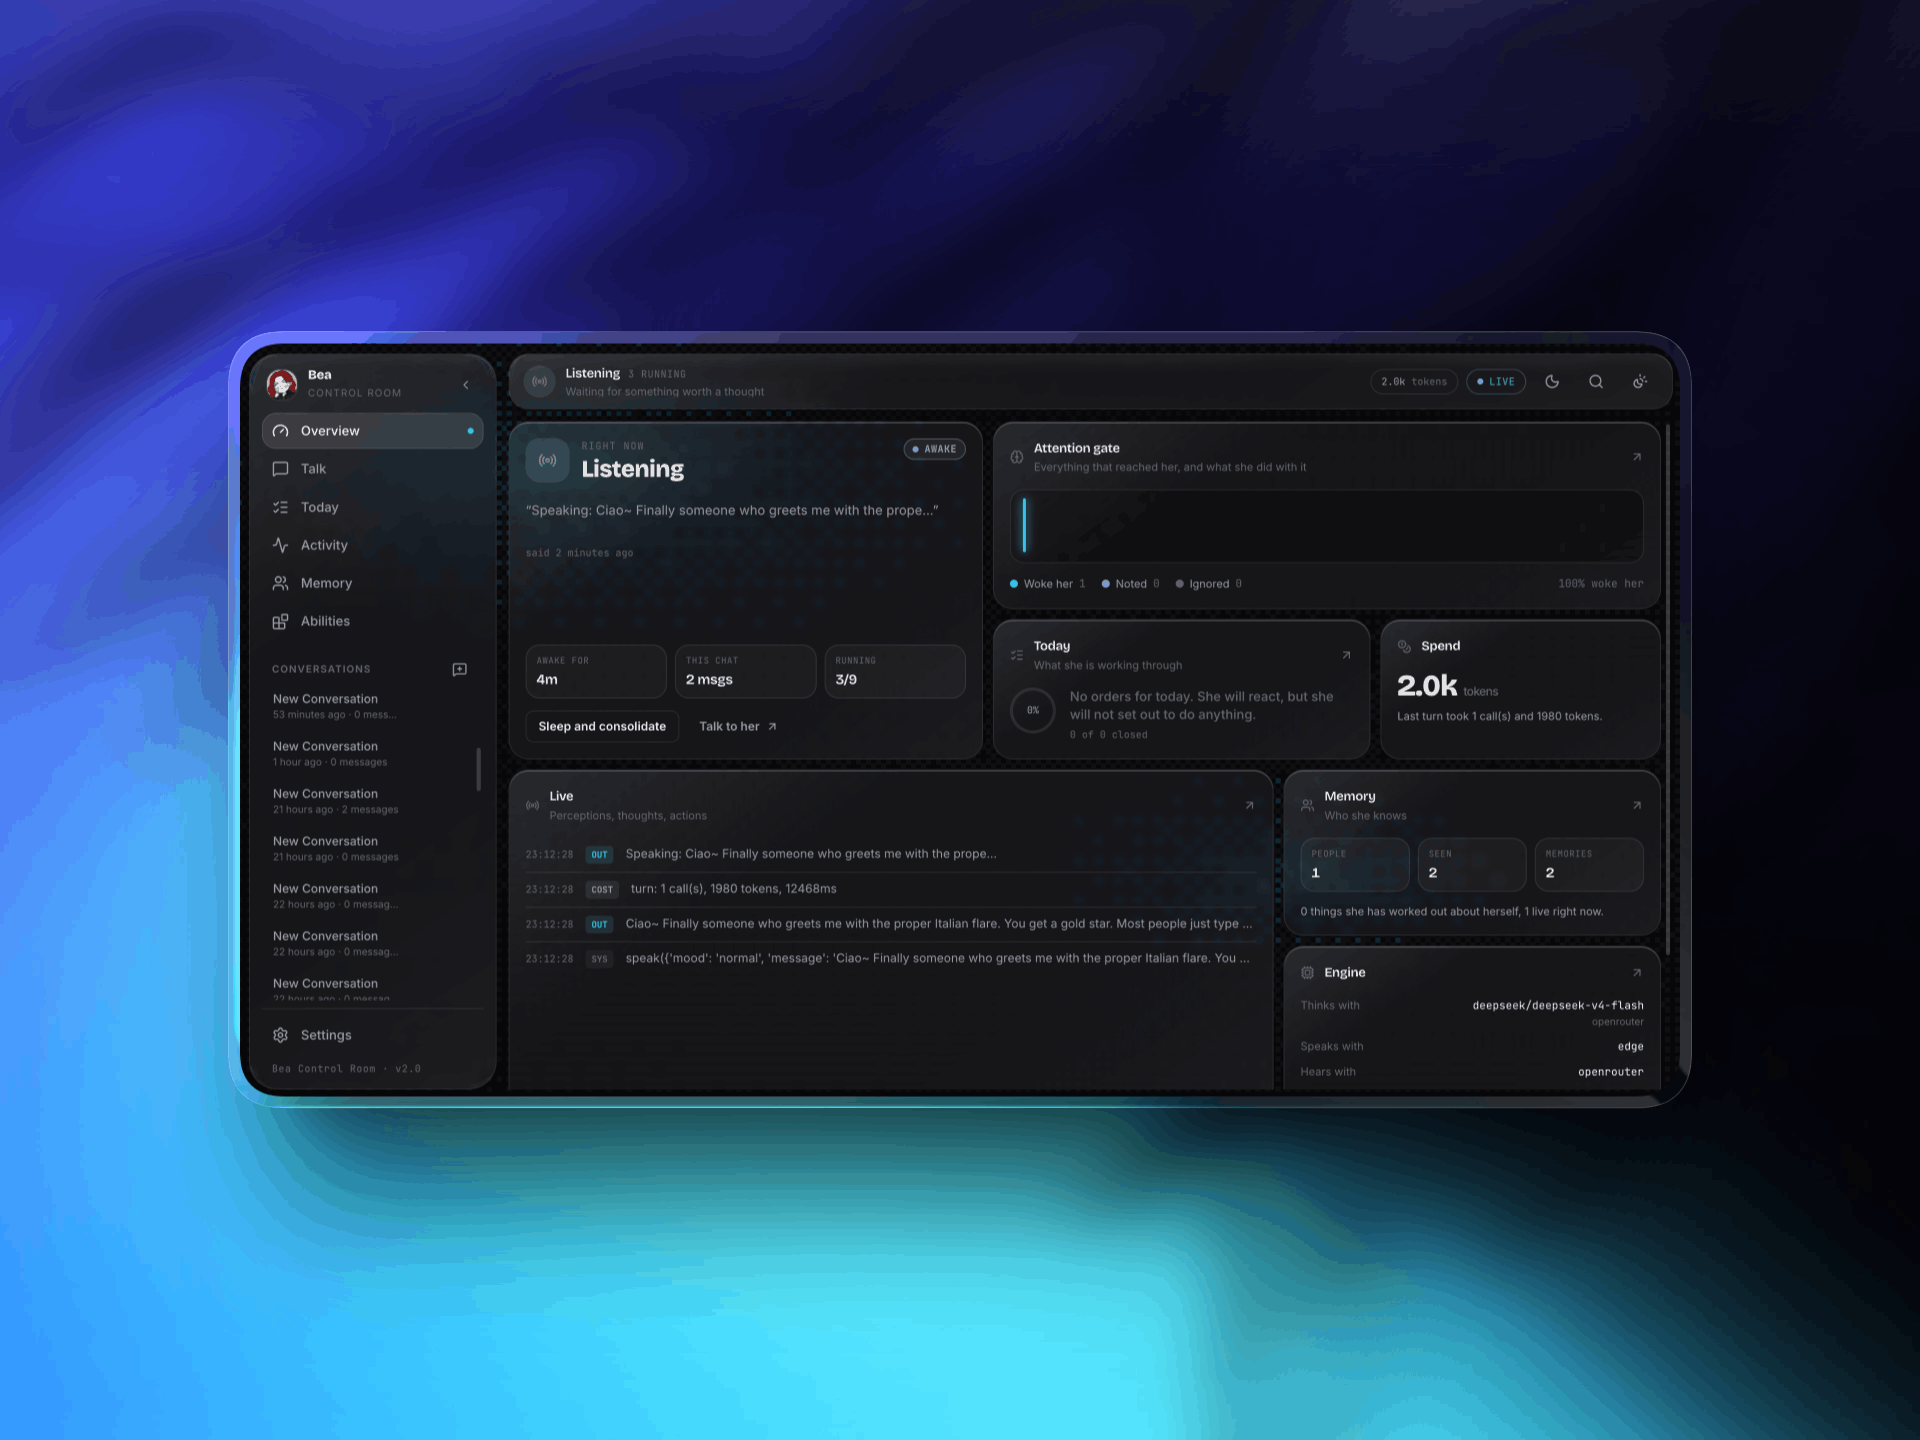
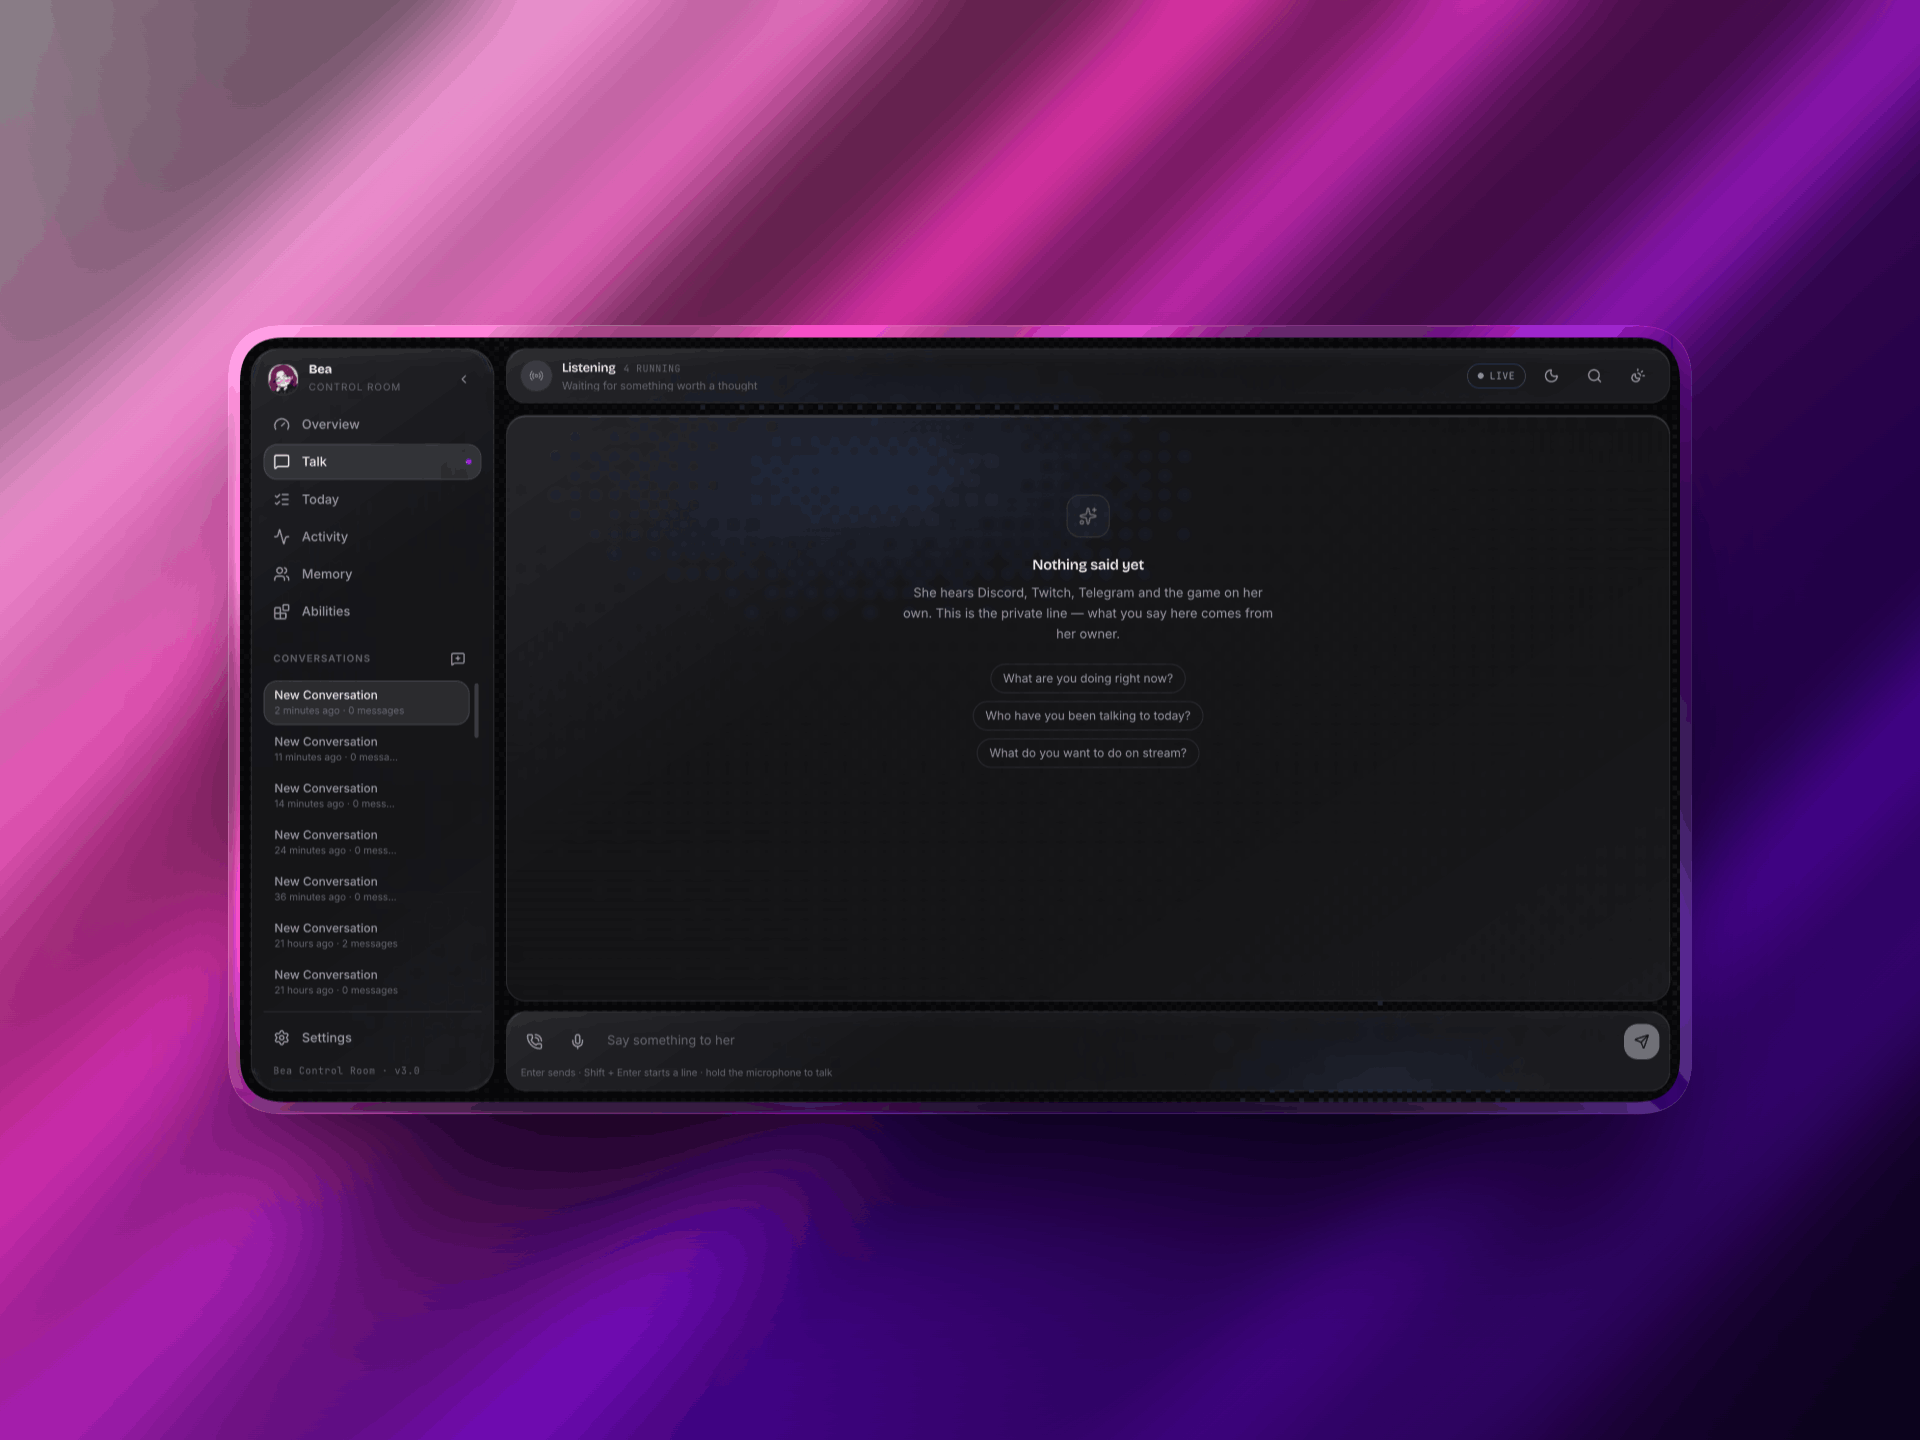
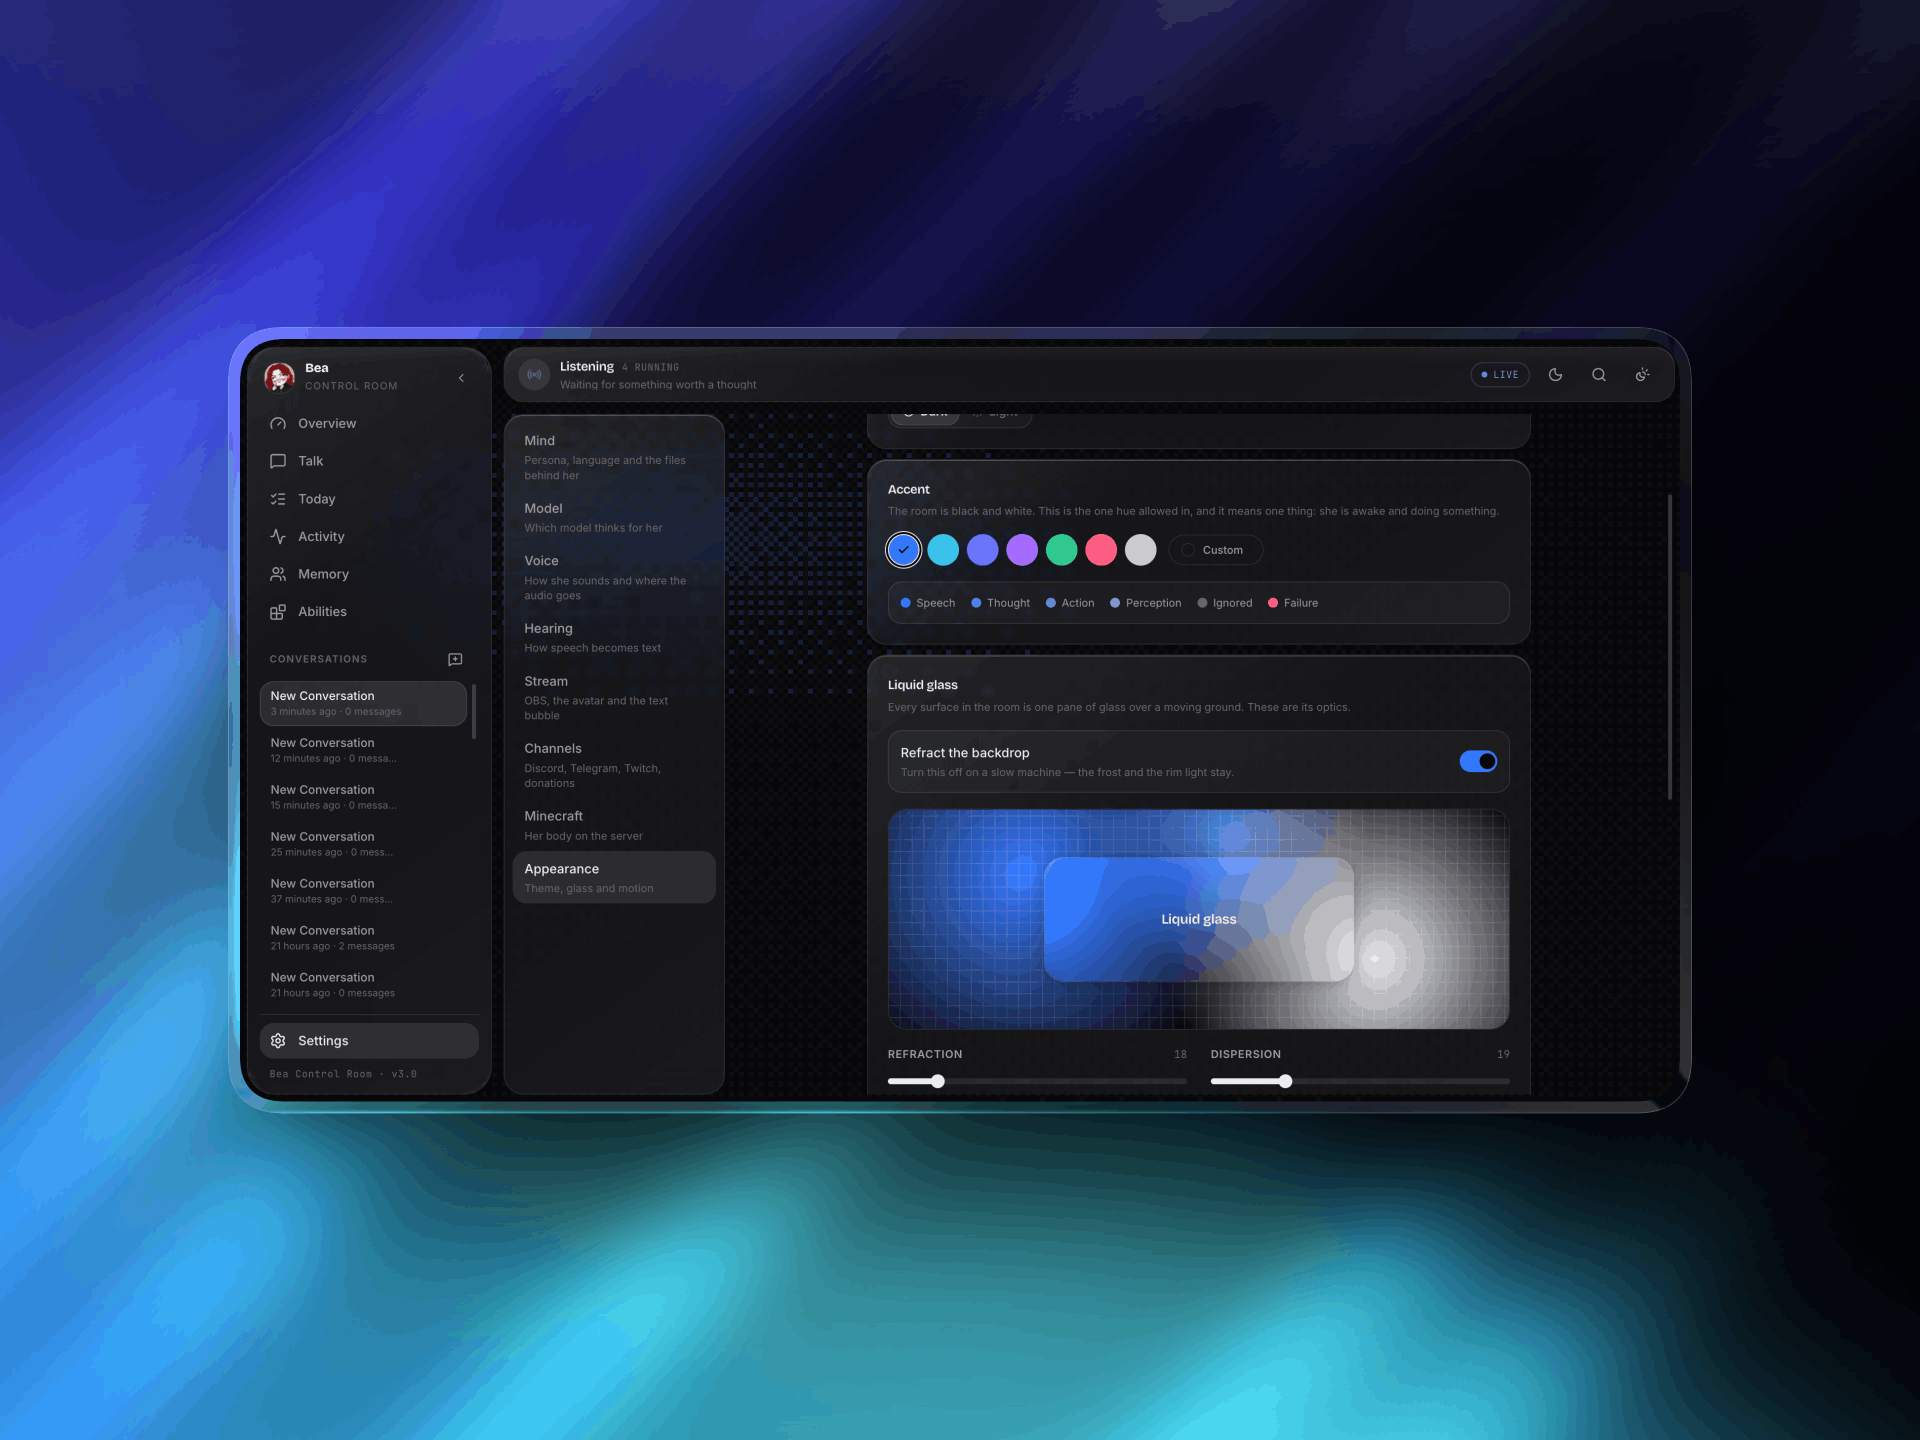
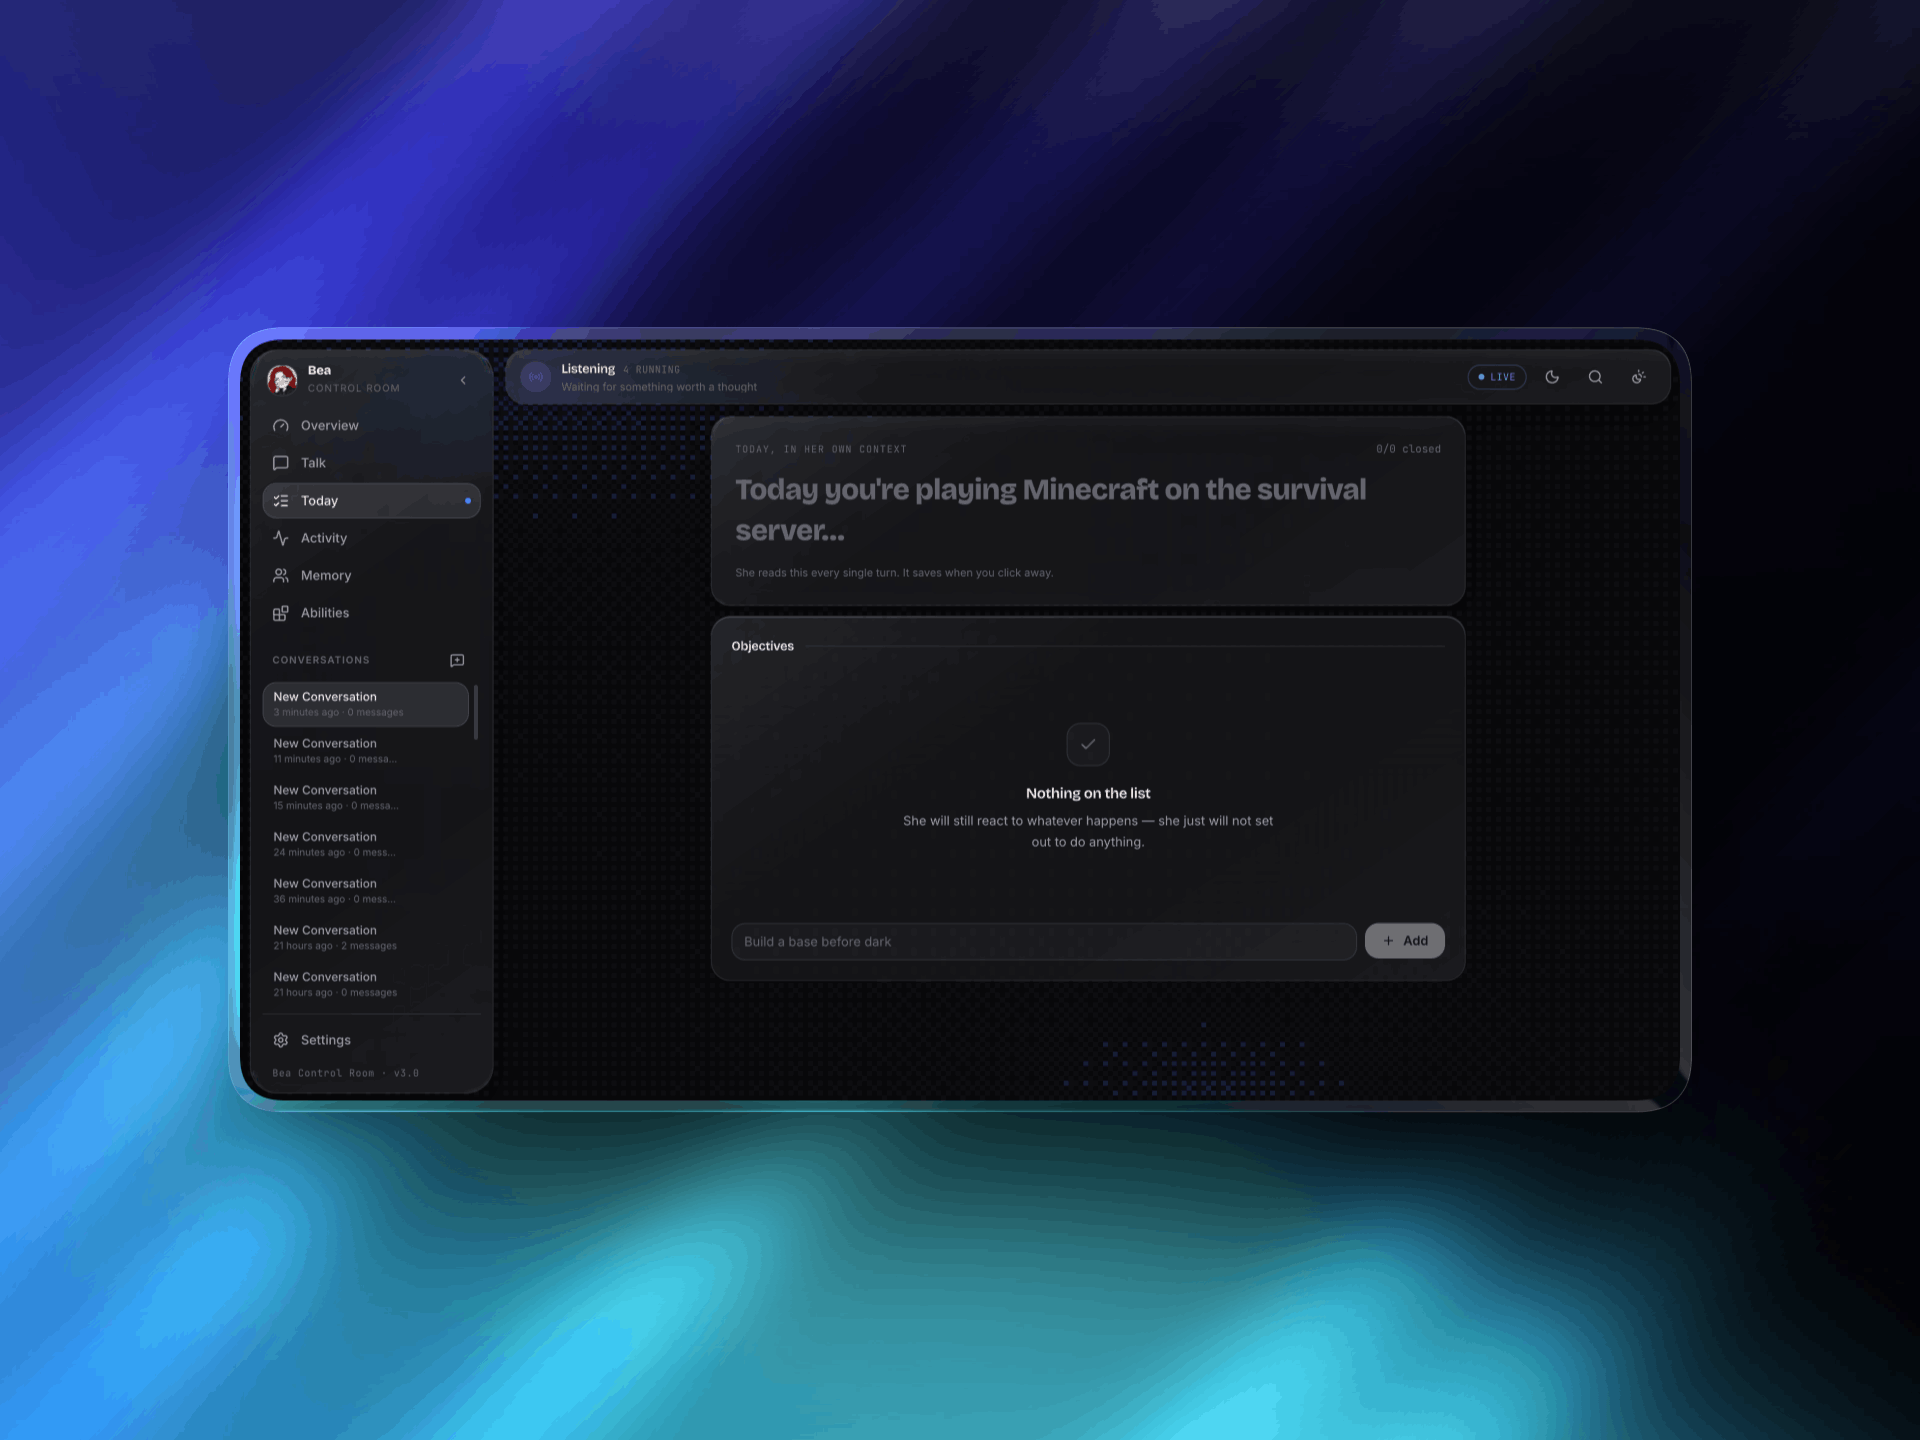
Volevo che chiunque potesse farla girare. È open source e self-hosted. Otto provider di modelli stanno dietro un'unica interfaccia, in pool per ruolo che ruotano e passano al successivo quando uno cade, e uno di questi è il tuo computer: con Ollama o LM Studio, un whisper locale e Kokoro, gira senza nemmeno una API key. Una skill web le permette di cercare e leggere pagine; è spenta di default e rifiuta gli indirizzi privati. L'aggiornamento unisce le tue modifiche ai suoi prompt invece di sovrascriverle, e una control room in React e FastAPI mostra tutto quello che sta facendo.
Galleria
Vuoi qualcosa del genere?
Posso costruire la stessa cosa per il tuo prodotto.
Raccontami cosa hai in mente. Ricevi una risposta in giornata, con uno scope e dei tempi realistici, non una proposta di vendita.